Sử dụng các dịch vụ trí tuệ nhân tạo trực tuyến mang lại sự tiện lợi, nhưng lại tiềm ẩn nguy cơ rò rỉ dữ liệu nội bộ và phụ thuộc vào kết nối mạng cũng như chi phí thuê bao hàng tháng. Việc tự chạy một mô hình trí tuệ nhân tạo cục bộ trực tiếp trên máy tính cá nhân là giải pháp tối ưu cho những ai đề cao tính riêng tư.
Trước đây, việc vận hành các mô hình ngôn ngữ lớn đòi hỏi dàn máy trạm trang bị card đồ họa đắt tiền với dung lượng bộ nhớ VRAM khổng lồ. Nhờ những bước tiến vượt bậc của định dạng nén GGUF và các công cụ tối ưu hóa CPU, bạn hoàn toàn có thể chạy mượt mà các mô hình ngôn ngữ hiện đại trên chiếc máy tính văn phòng thông thường.
Mô hình cục bộ mang lại sự an toàn tuyệt đối về dữ liệu, nhưng đối với các tác vụ lập luận đa bước phức tạp hoặc xử lý ngữ cảnh hàng triệu token, bạn có thể tham khảo thêm bài phân tích đánh giá hiệu năng Gemini Flash để phối hợp linh hoạt giữa hai giải pháp.
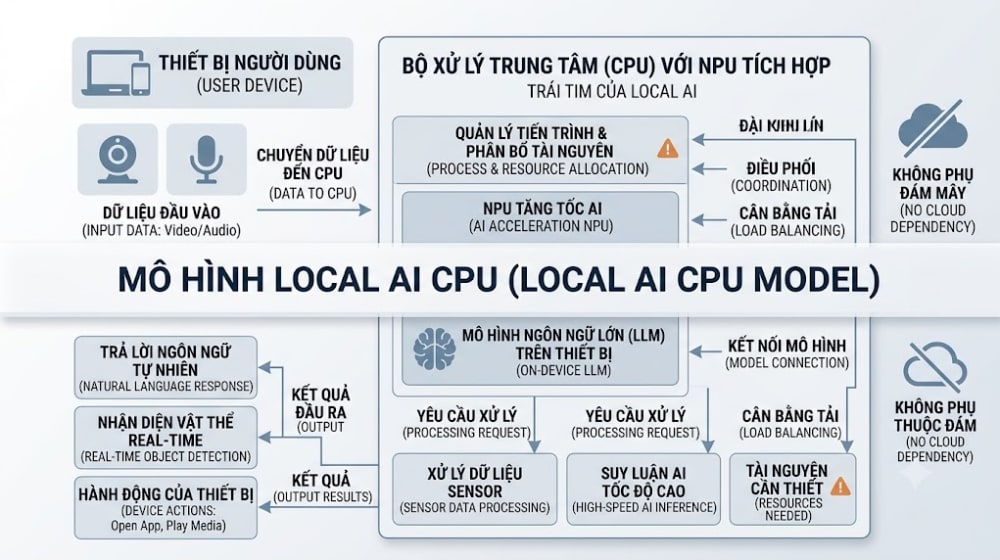
Nguyên lý vận hành mô hình ngôn ngữ lớn bằng CPU
Trở ngại lớn nhất của các mô hình ngôn ngữ truyền thống là kích thước tệp trọng số ở định dạng dấu phẩy động 16-bit quá lớn. Kỹ thuật lượng tử hóa giúp nén các trọng số này xuống mức 4-bit hoặc 5-bit mà chỉ làm suy giảm một tỷ lệ độ chính xác rất nhỏ.
Nhờ đó, toàn bộ mô hình ngôn ngữ có thể nằm gọn trong bộ nhớ RAM máy tính. Tập lệnh tăng tốc phần cứng AVX2 trên các dòng vi xử lý Intel và AMD hiện đại sẽ đảm nhận việc tính toán ma trận với tốc độ phản hồi từ 10 đến 25 từ mỗi giây, hoàn toàn đáp ứng tốt nhu cầu đọc và hỗ trợ viết tài liệu hàng ngày.
Lựa chọn kích thước mô hình phù hợp với dung lượng RAM
Trước khi tải mô hình, bạn cần đối chiếu chính xác dung lượng RAM khả dụng trên máy tính để tránh hiện tượng tràn bộ nhớ khiến hệ điều hành bị đơ cứng.
| Dung lượng RAM tối thiểu | Kích thước mô hình đề xuất | Tên mô hình tiêu biểu | Nhu cầu sử dụng phù hợp |
|---|---|---|---|
| 8 GB RAM | Dưới 4 tỷ tham số (1B - 3B) | Llama 3.2 3B, Qwen 2.5 3B | Tóm tắt nhanh văn bản, dịch thuật ngắn |
| 16 GB RAM | Từ 7 đến 8 tỷ tham số (7B - 8B) | Llama 3.1 8B, Mistral 7B | Viết lách chuyên sâu, giải thích mã nguồn |
| 32 GB RAM | Từ 14 tỷ tham số trở lên (14B) | Qwen 2.5 14B, DeepSeek 14B | Phân tích logic phức tạp, viết code chuẩn |
Cài đặt và tương tác mô hình qua công cụ Ollama
Ollama là giải pháp gọn gàng và ổn định nhất để quản lý các mô hình ngôn ngữ cục bộ trên Linux, macOS và Windows. Công cụ đóng gói toàn bộ nhân tính toán vào một dịch vụ nền duy nhất.
Mở cửa sổ dòng lệnh Terminal trên hệ điều hành Linux và chạy lệnh cài đặt tự động:
curl -fsSL https://ollama.com/install.sh | shSau khi tiến trình cài đặt hoàn tất, bạn có thể tải và trò chuyện trực tiếp với mô hình Llama 3.2 dung lượng nhẹ chỉ với một dòng lệnh duy nhất:
ollama run llama3.2:3bHệ thống sẽ tự động tải tệp trọng số về máy và hiển thị dấu nhắc lệnh để bạn bắt đầu đặt câu hỏi ngay lập tức. Toàn bộ quá trình xử lý văn bản đều diễn ra 100% ngoại tuyến trên phần cứng của bạn mà không gửi bất kỳ gói tin nào ra máy chủ bên ngoài.
- Local AI: Hệ thống trí tuệ nhân tạo được triển khai và tính toán hoàn toàn trực tiếp trên phần cứng máy tính cục bộ của người dùng.
- Lượng tử hóa: Kỹ thuật giảm độ chính xác của các trọng số số học trong mô hình để giảm dung lượng tệp và tốc độ tính toán.
- GGUF: Định dạng tệp lưu trữ mô hình nhị phân tiêu chuẩn được thiết kế tối ưu riêng cho việc nạp dữ liệu nhanh vào CPU và RAM.
- Ollama: Khung phần mềm mã nguồn mở cho phép tải, thiết lập và chạy các mô hình ngôn ngữ lớn thông qua dòng lệnh và cổng API cục bộ.
Chạy mô hình ngôn ngữ bằng CPU là giải pháp tuyệt vời để bảo vệ dữ liệu nhạy cảm và học tập công nghệ mà không tốn chi phí. Tuy nhiên, tốc độ sinh từ trên CPU sẽ bị suy giảm rõ rệt nếu bạn nạp các tài liệu đầu vào có độ dài vượt quá vài nghìn từ cùng lúc. Ngoài ra, các mô hình cỡ nhỏ (3B đến 8B) vẫn có thể xuất hiện hiện tượng bịa đặt thông tin nếu được hỏi về các kiến thức chuyên ngành quá sâu, do đó người dùng cần luôn kiểm chứng lại các kết quả quan trọng.